Acrobat OCR 光學字元辨識的原理與限制
- 症狀
- 掃描檔跑完 OCR 後可以搜尋文字,但比較檔案時只出現影像差異——OCR 到底做了什麼
- 適用產品
- Acrobat|不限
- 訂閱型態
- CCT 團隊版/CCE 企業版
OCR(Optical Character Recognition,光學字元辨識)的功能,是把圖片裡的文字「認」出來,讓掃描檔、截圖、拍照的紙本變成可以搜尋的內容。最普遍的應用就是整理筆記:紙本拍照後跑 OCR,之後用關鍵字就能搜到那一頁——不用一張一張翻。
OCR 之後,檔案還是影像
這是最容易誤會的一點:掃描檔跑完 OCR,預設是「可搜尋影像」——Acrobat 把認出來的文字疊成一層隱形文字層,鋪在原本的影像底下。你看到的頁面本體仍然是那張圖,所以可以搜尋、可以反白複製,但頁面不會因此變成一份「文字檔」。
要把掃描頁真正轉成可編輯的文字,得在 Acrobat 用「編輯 PDF」讓它把辨識結果轉換成可編輯內容(詳見下方官方說明),轉出來的字型與版面會盡量貼近原稿,但和原生的文字 PDF 仍是兩回事。
為什麼比較檔案只出現「影像差異」
Acrobat 的「比較檔案」功能,比對原生文字 PDF 時能逐字標出增刪;但拿兩份掃描檔(即使跑過 OCR)去比,Acrobat 面對的本體是兩張圖片,所以只會回報「影像差異」——它比的是像素,不是文字。
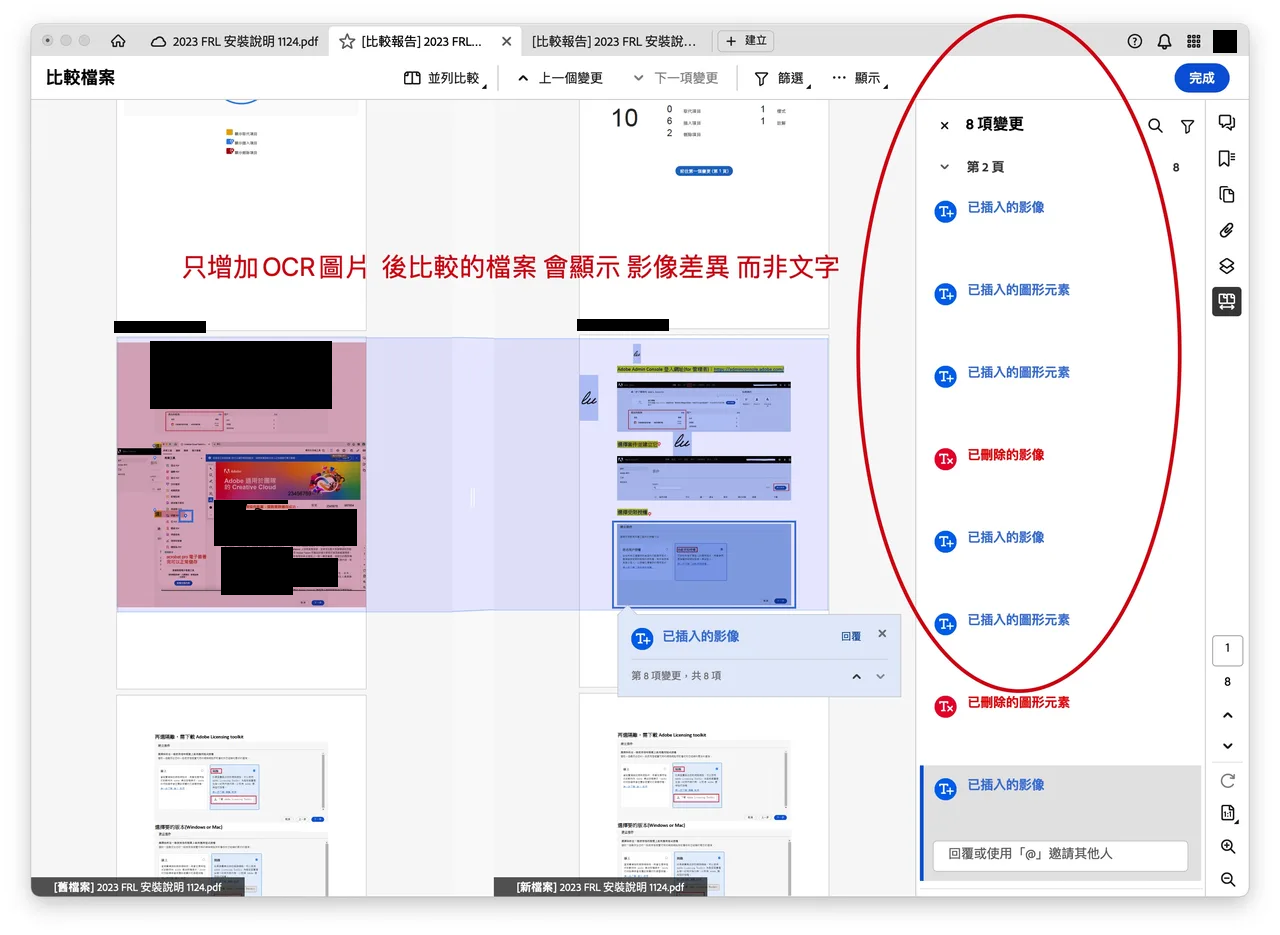
補充說明
給一個實用判準:需要「搜尋得到」,OCR 的預設輸出就夠了;需要「逐字比對或改字」,就得先把檔案轉成可編輯文字,或直接向對方要原生的文字版 PDF。合約、標單這類要逐字核對的文件,拿掃描檔比對永遠是下策——影像差異只能告訴你「這一塊不一樣」,不會告訴你差在哪個字。OCR 應用有疑問,請用下方 LINE 聯繫展碁支援。
參考來源
- 官方文件 Adobe 官方:在 Acrobat 中編輯掃描的 PDF 掃描 PDF 的 OCR 輸出與編輯轉換的官方說明
- 官方文件 Adobe 官方:在 Adobe Acrobat 中比較 PDF 檔案的兩個版本 比較檔案功能的官方說明
- 官方文件 Adobe Acrobat 官方頻道:What is OCR 教學影片 即本文內嵌影片
延伸資源
Adobe PDF & 輸出指南|2026 年版・從建檔到送印
Adobe 官方只發行日文版。這份繁體中文版由 AI 翻譯輔助製作,保留原版排版與所有連結;作為正式依據時請以原文版為準。
還是沒解決?
加入展碁國際 LINE 官方帳號,由代理商技術支援直接協助。
聯繫前請準備:
- 訂閱型態(CCT 團隊版/CCE 企業版)
- 作業系統與產品版本
- 錯誤訊息或錯誤代碼的截圖
- 是否有 Admin Console 管理權限
或來電 (02) 2371-6000 #770(週一至週五 09:00–17:00)
✓ 本文以 Acrobat(掃描與 OCR 功能) 驗證
最後更新:2025 年 03 月 28 日|以上內容由展碁國際整理